تقدّم الذكاء الاصطناعي ما زال هائلاً حتى حين يبدو مجرد إصدار نموذج جديد
أصبح من السهل التقليل من سرعة تقدم الذكاء الاصطناعي لأن التقدم يصل الآن على شكل إصدارات متكررة صغيرة بدلاً من قفزات مذهلة.
تشير بيانات جديدة من مؤشر Epoch للقدرات إلى أن أفضل نموذج ما زال يحسّن نتائجه بنحو 16 نقطة سنوياً، وأن طول المهمة التي يمكن للذكاء الاصطناعي إنجازها منفرداً يتضاعف تقريباً كل أربعة أشهر.
هذا يعني أننا نشهد زيادة بقدر حجم GPT 4 كل عام، بالرغم من أن أي حدث منفرد لا يبدو مهماً.
إيقاع الإصدارات هو الذي تغير.
تطلق المختبرات نماذج متتالية مثل GPT 5.4 ثم 5.5 ثم 5.6، ويرد المنافسون بإصدارات من عائلة Opus.
كل خطوة صغيرة تمر دون ضجة، لكنها في المجمل تنتج قدرات كانت تبدو خيالاً علمياً قبل عقد من الزمن.
قطاع التسويق يتأثر بهذه السرعة بشكل مباشر، لأن الأدوات الذكية أصبحت تدير البحث وإنتاج المحتوى وتحسين الحملات.
أي فريق لا يتابع منحنى القدرات الفعلي سيبني قراراته على نماذج قديمة عمرها سنتان.
الأرقام المذكورة تفسر أيضاً سبب إنفاق الشركات الكبرى على مراكز البيانات بشكل غير مسبوق.
التحسن لا يعود فقط إلى حجم المعاملات، بل إلى طرق تدريب أفضل وتصميمات أكثر كفاءة وتقنيات استدلال محسنة.
المرحلة القادمة لن تكون حول تعزيز النتائج الخام في الاختبارات، بل حول الموثوقية وتكلفة تنفيذ المهمة ومدى قدرة النموذج على العمل المتواصل دون تدخل بشري.
هذه المؤشرات تتحسن بسرعة أكبر مما توحي به المعايير المعروفة.
الدرس العملي لأي شركة تبني منتجات فوق نماذج لغوية هو تصميم النظام ليتعامل مع تغير النماذج باستمرار، بدلاً من افتراض أن الأساسات الحالية ستبقى ثابتة.
دراسة جديدة تكشف مفارقة بين سهولة القراءة وجودة إجابات المساعدات الذكية حول ألم الصدر عند الأطفال
نشرت مجلة PLOS دراسة جديدة قارنت استجابات ثلاثة من أشهر المساعدات الذكية، وهي ChatGPT وGemini وPerplexity، لأسئلة تتعلق بألم الصدر عند الأطفال.
هذا العرض السريري شائع في أقسام الطوارئ، لكنه يحمل في بعض الحالات إشارة إلى أمراض قلبية خطيرة.
وجد الباحثون مفارقة مستمرة بين سهولة القراءة وجودة الإجابة الطبية.
الردود التي يستطيع المرضى فهمها بسهولة كانت تفتقر غالباً إلى العمق السريري الذي يحتاجه الطبيب، بينما كانت الإجابات الأدق مكتوبة بلغة يصعب على الأهل فهمها.
هذه المفارقة ليست مجرد ملاحظة أكاديمية.
ألم الصدر عند الأطفال يكون في أغلب الحالات حميداً، لكنه قد يكون أول أعراض مرض قلبي نادر وخطير.
إذا أعطى الذكاء الاصطناعي إجابة مطمئنة غير دقيقة، فقد يتأخر الأهل في طلب الرعاية الطبية.
الدراسة لا تدّعي أن أي نموذج جاهز ليحل محل الطبيب.
بل تشير إلى مشكلة تصميم شائعة في أدوات الصحة الذاتية التي تعتمد على المساعدات المحادثة.
المساعدات الذكية تدرّب على أن تكون سلسة ومفيدة، لكنها ليست محسّنة للتعامل مع الحاجة إلى التريث الطبي، أو التعبير عن عدم اليقين، أو توجيه المستخدم إلى الطوارئ بوضوح.
النتائج تهم المرضى والآباء والمطورين.
أي شركة ناشئة تبني مساعداً طبياً يجب أن تدرك أن النموذج الحاصل على درجات عالية في الاختبارات قد يفشل في اللحظة الأعلى خطراً.
الخطوة التالية هي بناء مجموعات تقييم متخصصة تختبر المعرفة والأسلوب وسهولة القراءة والسلامة تحت الضغط.
وربما ستفرض الجهات التنظيمية لاحقاً مثل هذه الاختبارات قبل السماح لأدوات الذكاء الاصطناعي بالادعاء بفائدة سريرية.
شرح مثير للاهتمام يجعل المعرفة بآلية عمل المساعدات الرقمية ضرورة للجميع
ظهرت مقالة جديدة على منصة LessWrong وحظيت بانتشار واسع، لأنها تشرح كيفية عمل النماذج اللغوية الكبيرة دون أن تفترض أن القارئ يملك خلفية تقنية عميقة.
كاتبة المقالة مايا فاربر برودسكي كتبتها للأشخاص الذين يستخدمون ChatGPT وغيره من المساعدات يومياً، لكنهم لم يقرؤوا قط شرحاً واضحاً عن مصدر هذه الأنظمة.
الفكرة المركزية في المقالة هي أن الحيرة تجاه الذكاء الاصطناعي أمر طبيعي، لكن مقداراً صغيراً من المعرفة الأساسية يمكن أن يغير طريقة تقييم الناس لادعاءات الذكاء الاصطناعي.
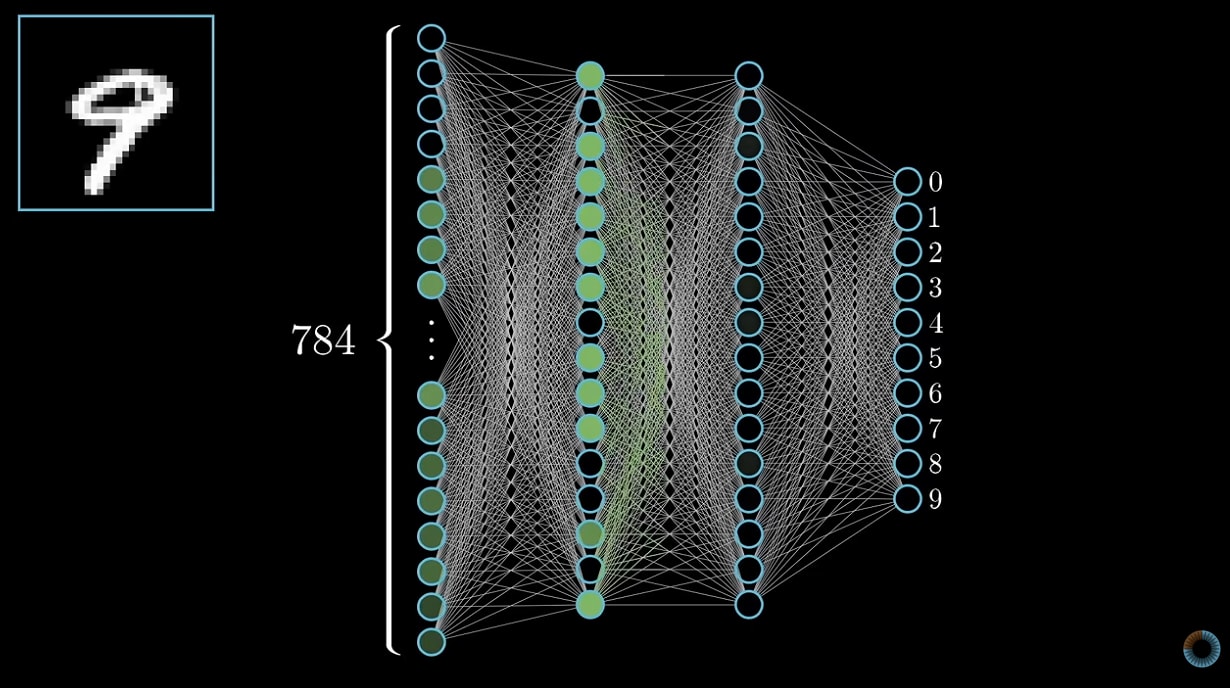
تستعرض المقالة كيف تتعلم النماذج من النصوص، وكيف ينتج التنبؤ بالرمز التالي محادثة كاملة، ولماذا تبدو المساعدات واثقة حتى عندما تكون مخطئة.
كما توضح أن التدريب على بيانات من الإنترنت يؤدي إلى طلاقة مذهلة وتحيزات عنيدة في الوقت نفسه.
برودسكي تقول إن النقاش العام يصبح أكثر صحة عندما يدرك الأشخاص أن النماذج اللغوية لا تصل إلى قاعدة بيانات حقائق، بل تولد الإجابات من الأنماط.
هذا التمييز مهم في مجالات مثل الاستشارات الطبية والبحث القانوني والواجبات المدرسية.
المقالة لاقت صدى لدى الباحثين لأنها تمنحهم طريقة بسيطة لشرح عملهم للأصدقاء والعائلة.
كما أنها تأتي في لحظة تحاول فيها المدارس وأماكن العمل تحديد شكل الثقافة الرقمية المطلوبة.
إذا أدرك عدد أكبر من الناس الفرق بين نظام استرجاع المعلومات والنموذج التوليدي، فسيطرحون أسئلة أدق، ويلتقطون الهلوسات في وقت أبكر، ويطالبون بوصف أكثر صدقاً للمنتجات.
الخطوة التالية هي تحويل هذه المعرفة الأساسية إلى مناهج دراسية وبرامج تدريب مهني، بدلاً من تركها لمنشورات تنتشر على الإنترنت.
هذه المقالة ليست مجرد شرح تقني، بل دعوة صريحة إلى تعزيز الوعي العام في لحظة أصبح فيها الذكاء الاصطناعي جزءاً من الحياة اليومية.
أكثر من ألف قائد في مجال الذكاء الاصطناعي يوقعون على دعوة لوقف تدريب النماذج المتقدمة ستة أشهر
نشر معهد مستقبل الحياة رسالة مفتوحة وقعها أكثر من ألف من الباحثين والتقنيين والمديرين التنفيذيين، تدعو جميع مختبرات الذكاء الاصطناعي إلى التوقف لمدة ستة أشهر عن تدريب أنظمة أكثر قدرة من نموذج GPT 4.
من بين الموقعين إيلون ماسك وستيف وزنياك، وهما شخصيتان نادراً ما تتفقان في الرأي.
التحذير الرئيسي في الرسالة هو أن النماذج الجديدة قد تصل إلى مستوى قدرات تنافسية بشرية في مجالات متعددة، وأن أدوات السلامة الحالية غير كافية لمنع الأضرار المحتملة.
لذلك تقترح الرسالة وقفاً مؤقتاً لتطوير بروتوكولات حوكمة مشتركة ومعايير تدقيق وطرق تحقق قبل إطلاق الجيل التالي.
هذه الدعوة طموحة وقد يكون تطبيقها مستحيلاً من الناحية العملية.
لا توجد حتى الآن آلية قانونية واضحة تمنع مختبراً خاصاً من تشغيل عملية تدريب جديدة.
والمنافسة بين الشركات على أشده.
ومع ذلك تمكنت الرسالة من تغيير طبيعة النقاش العملي.
فقد دفعت OpenAI وGoogle وAnthropic إلى تقديم تفسيرات علنية حول إجراءات السلامة، وأعطت الجهات التنظيمية فرصة لاقتراح أنظمة ترخيص للنماذج المتقدمة.
لم يعد السؤال حول ما إذا كان الذكاء الاصطناعي قادراً على إحداث ضرر، بل حول من يملك سلطة تحديد اللحظة التي يصبح فيها النموذج خطراً على المجتمع.
الردود المعارضة للرسالة تقول إن وقف التدريب قد يفيد فقط الشركات الكبيرة التي تملك ميزانيات انتظار طويلة، فيما ستستمر المجتمعات مفتوحة المصدر في إصدار نماذج دون رقابة.
المؤيدون يرون أن هذه التقنية تمتلك قدرة على التوسع والاستقلالية بشكل لم يسبق له مثيل.
KDE وGNOME يضعان قواعد للتعامل مع التعديلات البرمجية المولدة بالذكاء الاصطناعي
بدأ المطورون المسؤولون عن بيئتي سطح المكتب KDE وGNOME يواجهون نوعاً جديداً من المساهمين، هو نموذج لغوي كبير قادر على إنتاج تعديلات برمجية ووثائق وحتى ميزات كاملة خلال ثوان.
نقاش بدأ في موقع Slashdot تحول إلى ملف حوكمة ملحّح بالنسبة لأكثر بيئات لينكس انتشاراً.
المشكلة الأساسية بسيطة: هذه النماذج تستطيع كتابة تعليمات برمجية تبدو أنيقة وتجتاز الاختبارات الأولية، لكن لا أحد يعرف من يتحمل المسؤولية إذا أدخلت هذه التعليمات خطأ خفياً أو انتهكت ترخيصاً أو أضعفت الأمان.
عندما يقدم إنسان تعديلاً سيئاً، يمكن للمشرف أن يطلب تصحيحاً.
أما عندما يقدم برنامج نصي يعتمد على كود محمي بحقوق النشر، فقد يتعرض المشروع بأكمله لمشاكل قانونية.
KDE وGNOME يعتمدان على وقت المتطوعين، ومراجعة المساهمات المولدة آلياً قد تستنزف ذلك الوقت بسرعة.
بعض المشرفين يريدون رفض أي كود مولد بالذكاء الاصطناعي ما لم يُذكر ذلك بوضوح.
آخرون يريدون توظيف أدوات الذكاء الاصطناعي لاكتشاف المساهمات الضعيفة قبل أن يقرأها أي إنسان.
هذه المعضلة ليست حكراً على بيئات سطح المكتب.
إنها تؤثر على كل مشروع مفتوح المصدر يقبل مساهمات خارجية.
لكن قرارات KDE وGNOME مهمة لأن هذه المشاريع تمثل الواجهة الافتراضية لملايين المستخدمين.
ما ستقومان به الآن سيرسم معالم سياسة قادمة تعتمد على الإفصاح عن الكود المولد آلياً ومراجعة مصدره.
هذه السياسة قد تصبح نموذجاً يحتذى به في النظام البيئي المفتوح كله.