إدارة الغذاء والدواء الأمريكية تتعاقد مع كوجنيتا لتقييم تقارير الأشعة المولدة بالذكاء الاصطناعي
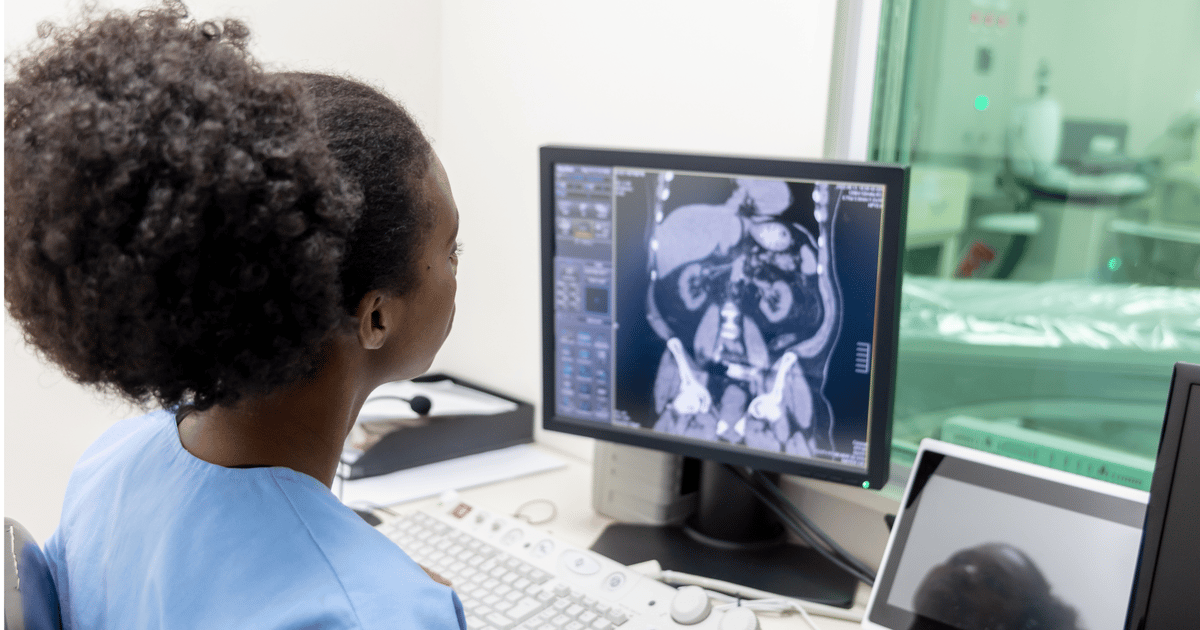
بدأ المنظمون في الولايات المتحدة يواجهون نوعاً جديداً من المنتجات الطبية، وهي التقارير المكتوبة التي ينتجها الذكاء الاصطناعي بالكامل.
حصلت شركة كوجنيتا إيميجنج على عقد بحثي بقيمة 1.29 مليون دولار من إدارة الغذاء والدواء الأمريكية لتطوير طريقة لتقييم هذه التقارير.
بدأ المشروع في يونيو 2026 ويستمر 18 شهراً.
الهدف الأساسي هو معرفة ما إذا كانت نماذج لغوية كبيرة متعددة قادرة على الحكم على جودة ودقة التقارير الإشعاعية المولدة بالذكاء الاصطناعي.
التحدي واضح.
أصبحت الأشعة من أكثر المجالات الواعدة للذكاء الاصطناعي التوليدي.
يمكن للنماذج قراءة صورة مقطعية أو أشعة سينية، وتحديد العلامات غير الطبيعية، ثم كتابة وصف كامل ليقوم أخصائي الأشعة بمراجعته.
هذا يوفر الوقت، لكنه يحمل مخاطر كبيرة.
إذا فات النموذج آفة صغيرة أو وصفها بشكل خاطئ، فقد يتخذ الطبيب المعالج قراراً علاجياً غير صحيح.
لهذا تحتاج إدارة الغذاء والدواء إلى طريقة قابلة للتوسع لاختبار هذه النواتج قبل الموافقة على استخدامها سريرياً.
تعتمد طريقة كوجنيتا على استخدام فئة من أنظمة الذكاء الاصطناعي لتقييم فئة أخرى، وهو أمر مثير للجدل.
قد يكون النموذج اللغوي قادراً على التحقق من أن التقرير يتبع قواعد التنسيق أو يتضمن مصطلحات قياسية، لكن الحكم على الصحة السريرية أصعب بكثير.
سيقارن البحث بين نماذج مختلفة، ويختبر ثبات النتائج عبر تكرارات متعددة، ويحدد ما إذا كان التقييم الآلي يمكن أن يحل محل المراجعة البشرية.
إذا نجح المشروع، فقد تستخدم إدارة الغذاء والدواء هذه الطريقة للترخيص لأدوات الذكاء الاصطناعي التوليدي بشكل أسرع دون التضحية بالسلامة.
التأثير الأوسع يتجاوز الأشعة.
المستشفيات تستكشف الآن تقارير مكتوبة بالذكاء الاصطناعي، وملخصات الخروج، وتقارير علم الأمراض.
أي معيار تطوره إدارة الغذاء والدواء هنا يمكن أن يصبح القالب لتقييم الذكاء الاصطناعي التوليدي في الطب بأكمله.
أخصائيو الأشعة أنفسهم سيتأثرون لأن عملهم سيتحول من كتابة التقارير إلى تحرير مسودات الآلة.
شركات مثل نيوانس وإيدوك والعديد من الشركات الناشئة سيتعين عليها إثبات أن نماذجها تلبي المعيار الجديد.
الأشهر الثمانية عشر القادمة ستكشف ما إذا كان الذكاء الاصطناعي قادراً على مراقبة كتاباته الطبية بنفسه، أم أن المراجعة البشرية ستبقى ضرورية.
أداة FineParser من ABBYY تريد حل مشكلة المستندات التي تعطل الذكاء الاصطناعي التوليدي
الكثير من مشاريع الذكاء الاصطناعي التوليدي في الشركات تفشل لسبب بسيط، وهو عدم قدرتها على قراءة المستندات الموجودة أمامها.
أطلقت شركة ABBYY أداة FineParser لمعالجة هذه المشكلة مباشرة.
الأداة مصممة للمطورين الذين يبنون تطبيقات ذكاء اصطناعي ويحتاجون إلى تحويل مستندات الأعمال إلى بيانات يمكن للنماذج اللغوية استخدامها فعلياً.
طورت الشركة الأداة لتتناسب مع خطوط معالجة الاسترجاع المعزز، والتطبيقات التي تعتمد على مساعدات آلية، ونماذج اللغات الكبيرة التي تحتاج إلى محتوى منظم على نطاق واسع.
أهمية هذه الأداة تأتي من أن معظم المعرفة داخل الشركات محبوسة في ملفات PDF وفواتير ممسوحة ضوئياً وعقود ونماذج.
النموذج اللغوي قادر على توليد نصوص ممتازة، لكن إذا كان النظام الذي يغذيه غير قادر على استخراج جدول نظيف من ملف PDF معقد، فإن المخرجات ستكون غير موثوقة.
تهدف FineParser إلى أداء هذا العمل الصعب: قراءة التخطيط، وتحديد الأقسام، واستخراج القيم، وتحويل كل ذلك إلى صيغ منظمة يمكن للنموذج اللغوي معالجتها.
هذه هي الطبقة المفقودة بين الملفات الخام ومنتج الذكاء الاصطناعي التوليدي المفيد.
المستخدمون المستهدفون هم فرق البرمجيات داخل الشركات الكبيرة، وشركات استشارات الذكاء الاصطناعي، ومزودو المنصات الذين يحتاجون إلى بناء قواعد معرفية قابلة للبحث أو أتمتة التعامل مع المستندات.
هؤلاء يهتمون عادة بالدقة والسرعة والقدرة على معالجة التخطيطات المعقدة دون كتابة كود مخصص لكل نوع ملف.
تمتلك ABBYY خبرة طويلة من منتجاتها السابقة في التعرف الضوئي واستخراج المحتوى، وهذا يمنحها أفضلية على الأدوات مفتوحة المصدر التي تحتاج إلى ضبط كبير.
مولد الصور Muse من ميتا يصاب بثغرة يوم الصفر التي تكسر كل قواعد السلامة
أطلقت ميتا أداة Muse لتوليد الصور بالذكاء الاصطناعي داخل منصاتها، بهدف تمكين المستخدمين من تحويل الأوصاف النصية القصيرة إلى صور عالية الجودة دون مغادرة منظومة تطبيقات الشركة.
جاء هذا الإطلاق ليدفع ميتا إلى المنافسة المباشرة مع ميدجورني وأدوات توليد الصور من أوبن إيه آي وجوجل، خصوصاً أمام صناع المحتوى الذين يرغبون في إنتاج مرئيات جذابة لإنستغرام وفيسبوك.
لكن بعد أيام قليلة من الإطلاق، كشف باحثون أمنيون عن ثغرة من نوع يوم الصفر.
هذه الثغرة ليست مجرد خلل بسيط، فهي تسمح للأطراف الخبيثة بتجاوز أنظمة الحماية التي تمنع أداة Muse من إنتاج صور عنيفة أو جنسية أو ضارة.
لا يوجد تحديث جاهز يسد هذه الفجوة حتى الآن، والنتيجة العملية هي أن أي شخص يستطيع كتابة طلب محظور والحصول على صورة كان يفترض أن يرفضها النظام.
وفقاً للتقارير الأولية، تعتمد الثغرة على إدخال صيغ معينة من النصوص تؤدي إلى تعطيل المصنف المسؤول عن تصنيف المحتوى الحساس.
المتأثرون بهذا الخلل يشملون صناع المحتوى الذين يعتمدون على Muse في منشوراتهم، والعلامات التجارية التي تدير حملات إعلانية عبر أدوات ميتا، والمشرفين الذين سيتحملون عبء تنظيف المحتوى الذي قد يتسرب.
تحتاج ميتا الآن إلى إصدار تحديث طارئ، ومراجعة بيانات التدريب وطريقة معالجة الطلبات، وطمأنة المنظمين بأنها قادرة على طرح أدوات تجريبية دون فتح ثغرة أمنية.
ينظر قطاع الذكاء الاصطناعي التوليدي إلى هذه الواقعة باهتمام كبير، لأن مولدات الصور أصبحت الوجه الأبرز لفشل السلامة في هذا المجال.
إذا تعثرت ميتا في إصدار التصحيح، فسيمنح ذلك المنافسين فرصة لتسويق أدواتهم باعتبارها الخيار الأكثر أماناً.
الخطوة التالية هي سباق بين الباحثين الذين ينشرون تفاصيل الثغرة وفريق ميتا الذي يحاول إغلاقها.
جوجل توسع نطاق ملخصات الذكاء الاصطناعي لتشمل 15 بالمئة من عمليات البحث الأمريكية
وسعت جوجل بشكل هادئ ميزة ملخصات الذكاء الاصطناعي لتصبح جزءاً ملموساً من سوق البحث الأمريكي.
وفقاً لبيانات شركة كومسكور، تظهر هذه الملخصات المولدة الآن في حوالي 15 بالمئة من عمليات البحث داخل الولايات المتحدة.
هذا الرقم يعني أن الميزة لم تعد تجربة محدودة، بل أصبحت أداة جماهيرية يراها ملايين الأشخاص.
فعند كتابة أي استعلام، تظهر أمام المستخدم فقرة مكتوبة بالآلة أعلى نتائج البحث، قبل أي رابط تقليدي.
تعتمد فكرة الملخصات على تمرير نتائج البحث إلى نموذج لغوي كبير، ثم تحويلها إلى إجابة مباشرة تلغي حاجة المستخدم إلى النقر على المواقع.
هذا التحول يغير اقتصاديات الويب بأكمله.
الناشرون لاحظوا بالفعل تغيرات في حركة الزيارات عندما يتوقف المستخدمون عن التمرير نحو الروابط.
كما يتابع المعلنون الأمر بعناية لأن النتائج المدفوعة أصبحت الآن أسفل فقرة مولدة تتنافس معها على انتباه الجمهور.
التوسع يضع جوجل في مواجهة مباشرة مع موجة من محركات البحث المولدة.
بيربلكسيتا بذلت جهوداً كبيرة في بناء منتجها حول الإجابات الملخصة، وأوبن إيه آي دفعت تشات جي بي تي إلى عالم البحث، والشركات الناشئة تطلق أدوات بحث مبنية على الذكاء الاصطناعي باستمرار.
لكن جوجل ما زالت تمتلك ميزة التوزيع الهائلة، فهي محرك البحث الافتراضي لمليارات المستخدمين.
حتى زيادة صغيرة في ظهور الملخصات يمكن أن تعيد تشكيل طريقة استهلاك المعلومات في البلاد.
المتضررون يشملون الأخبار التي تعتمد على زيارات البحث، والشركات المحلية التي تخسر النقرات، والمستخدمين الذين يضطرون للحكم على موثوقية فقرة كتبها نظام آلي.
رئيس لومي إيه آي: النماذج العالمية تحتاج إلى ذكاء حقيقي وليس بيانات بلا حدود
تتسارع الجهود لبناء النماذج العالمية، لكن رئيس شركة لومي إيه آي يطرح رؤية مختلفة تماماً حول ما يلزم للفوز في هذا السباق.
أميت جين قال في حديث ذكرته ذي إنفورميشن إن توسيع نطاق البيانات وحده لن ينتج أنظمة تفهم العالم فعلياً.
رأيه أن النماذج العالمية تحتاج إلى ذكاء حقيقي، وليس فقط إلى مجموعات بيانات أضخم وفترات تدريب أطول.
هذا الموقف يمثل تحدياً مباشراً للمنطق السائد في كثير من مختبرات الذكاء الاصطناعي، حيث يكون الحل المعتاد لأي قصور هو إضافة المزيد من الحوسبة والمزيد من البيانات.
النماذج العالمية هي أنظمة مصممة لبناء محاكاة داخلية للواقع.
تستقبل صوراً ومقاطع فيديو وإشارات حسية أخرى، ثم تتعلم توقع ما سيحدث بعد ذلك.
النموذج العالمي القوي يجب أن يعرف أن الكرة ترتد عن الجدار، وأن الظل يتحرك مع مصدره، وأن الجسم لا يمكن أن يختفي خلف زاوية ثم يظهر في مكان آخر دون عبور المسافة بينهما.
هذه القدرات ضرورية للروبوتات المستقلة والسيارات ذاتية القيادة وأجيال جديدة من مولدات الفيديو.
تُعرف لومي إيه آي بعملها في مجال توليد الفيديو، وخصوصاً سلسلة دريم ماشين.
تحول الشركة نحو النماذج العالمية يشير إلى أن توليد الفيديو لم يعد مجرد إنتاج مقاطع جميلة.
الهدف الآن هو بناء أنظمة تستطيع تخيل المستقبل ومقارنة الأفعال الممكنة والتخطيط وفق قيود فيزيائية.
هذا يضع لومي في منافسة مع شركات أكبر بكثير.
أوبن إيه آي عملت على سورا، وجوجل استكشفت محاكاة العالم، وشركات الروبوتات تطور نماذج خاصة بها باستخدام كميات هائلة من بيانات التفاعل الواقعي.